 蛋哥AI
AI 视频AI 工具
Hedra
斯坦福团队做的角色视频模型:一张头像加一段音频,人物开口说话还带表情,口型对得上。播客做成动画、让角色唱歌,这活它最拿手。
视频生成数字人境外收录于 2026.11.10 · Hedra 实测整理
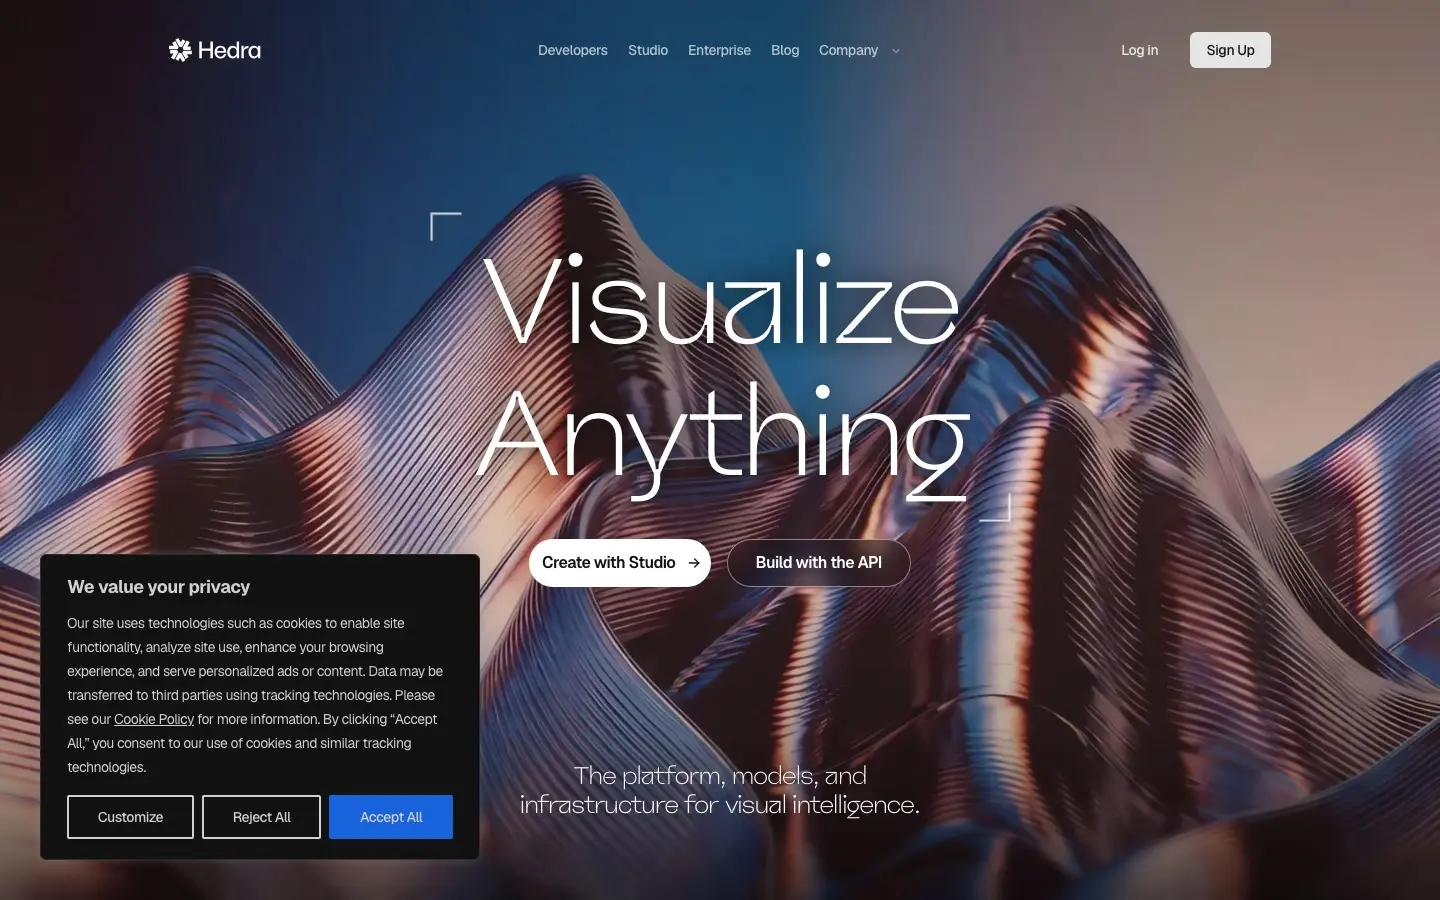 官网首屏截图
HedraAI 视频 · 官网截图
01照片音频生成说话视频
02口型表情节拍同步
03唱歌播客动画拿手
让静止头像开口
上传角色图和音频,模型生成唇形、表情、姿态都同步的说话视频,自研的角色模型撑底。特写构图的表现力尤其好,情绪给得很足,细节经得起细看。
唱歌场景是主场
音乐和对白是它区别于口播数字人的地方:角色能跟着节奏做表演,翻唱、播客片段配动画这些玩法,出片效果在同类里排前列,圈子里模板满天飞。
同类怎么选
商务口播和企业培训视频,Heygen、Synthesia 流程更成熟;控制角色做动作选 Viggle。Hedra 卡的是表演和对口型这一格,唱歌内容没有对手。
什么时候别用它
单段视频时长按档位封顶,长内容要拼接;画面比例以方形和竖版为主,横屏项目先确认支持。正经企业口播还是选流程更工业化的数字人平台。